

存储这个话题两层:单机上磁盘和协议怎么选,跨机器时数据怎么切分存放。这篇从存储协议讲起,过一遍 DAS/NAS/SAN/对象存储的演化,再梳理 Ceph、FastDFS、GlusterFS 三个主流分布式方案的定位与差异。
存储协议与四种存储形态
接口协议常见有 IDE、SATA、SCSI、SAN、USB。按接入方式分:
- DAS(直连存储):磁盘直接接主板,第一代存储,经 SCSI 总线外接磁带阵列做服务器扩展,给一块 /dev/sdb 这样的裸盘就用。组网简单、成本低,但不能多主机共享、扩展性有限,如今很少使用。
- NAS(网络附加存储):文件系统级协议,常见 NFS、CIFS。远端机器本身是个文件系统,通过网络接口导出,客户端靠内核 NFS 模块挂载使用,挂上的空间不能再格式化、分区建块。CIFS 是跑在 TCP/IP 上的跨平台 C/S 协议,即互联网场景下的 SMB 版本。NAS 使用简单、可多主机共享,但性能有限、可靠性一般。
- SAN(存储区域网络):块级接口,走 SCSI 协议。SCSI 和 TCP/IP 一样分层(物理层、传输层、指令层),早期靠并行 SCSI 线缆传信号、距离有限;把底层物理信道换掉就分出两派:FC SAN 用光纤通道传 SCSI,iSCSI 用互联网传 SCSI。性能、稳定性、扩展性都好,但成本高——FC 网络要 HBA 卡、FC 交换机和支持 FC 的存储,而且对带宽要求高。
- 对象存储:大数据时代 PB 级图片、视频等静态文件的解法。通过网络 API 访问无限扩展的分布式系统,兼容 S3 风格、原生 PUT/GET。扩展性极强、使用简单,但只适合静态不可编辑文件,给不了块级存储。
归结起来,企业里的存储形态无非三种:块设备、挂载目录当本地文件用、API 上传下载对象。每一种都诞生于特定的应用场景,各有优缺点。
磁盘设备的 IO 天花板
机械盘接口还是偏慢的 SATA,圆形盘片限制了尺寸:

SSD 从 SATA 走到 PCIe 和 NVME,IO 能力提升了数十倍:传统 IDE 理论值约 100 IOPS,SATA 接口固态约 500,NVME 接口固态在 2000-4000 不等:
但在高并发场景下,单块 NVME 盘既要扛磁盘 IO 又要配合网络 IO(比如大型电商),容量和吞吐都到顶。单机撑不住,就得靠分布式。
分布式存储的运行逻辑
分布式存储用计算机网络连接大量物理节点,把不同机器、不同磁盘、不同分区的数据组织成一个虚拟大存储池供上层使用,规模一般在 PB 级(1PB=1024TB),可靠性、可用性和存取效率都更高,也易于扩展。这个思路源自 Google GFS 的论文(2005 年前后发表),Hadoop 参考它实现了开源的 HDFS。
核心两类角色:元数据(NameNode,存路由信息)和数据(DataNode,存业务数据)。写入时,客户端把存储请求发给元数据节点,按指定规模切块——比如 64M 一块,这里的块和本机文件系统的块是两回事——第一块交给一台服务器、第二块交给另一台,充分利用多节点的网络和磁盘 IO;读取时先问元数据:文件切了几块、每块在哪、块间怎么偏移,然后并行拉取、按元数据逻辑拼回完整文件。
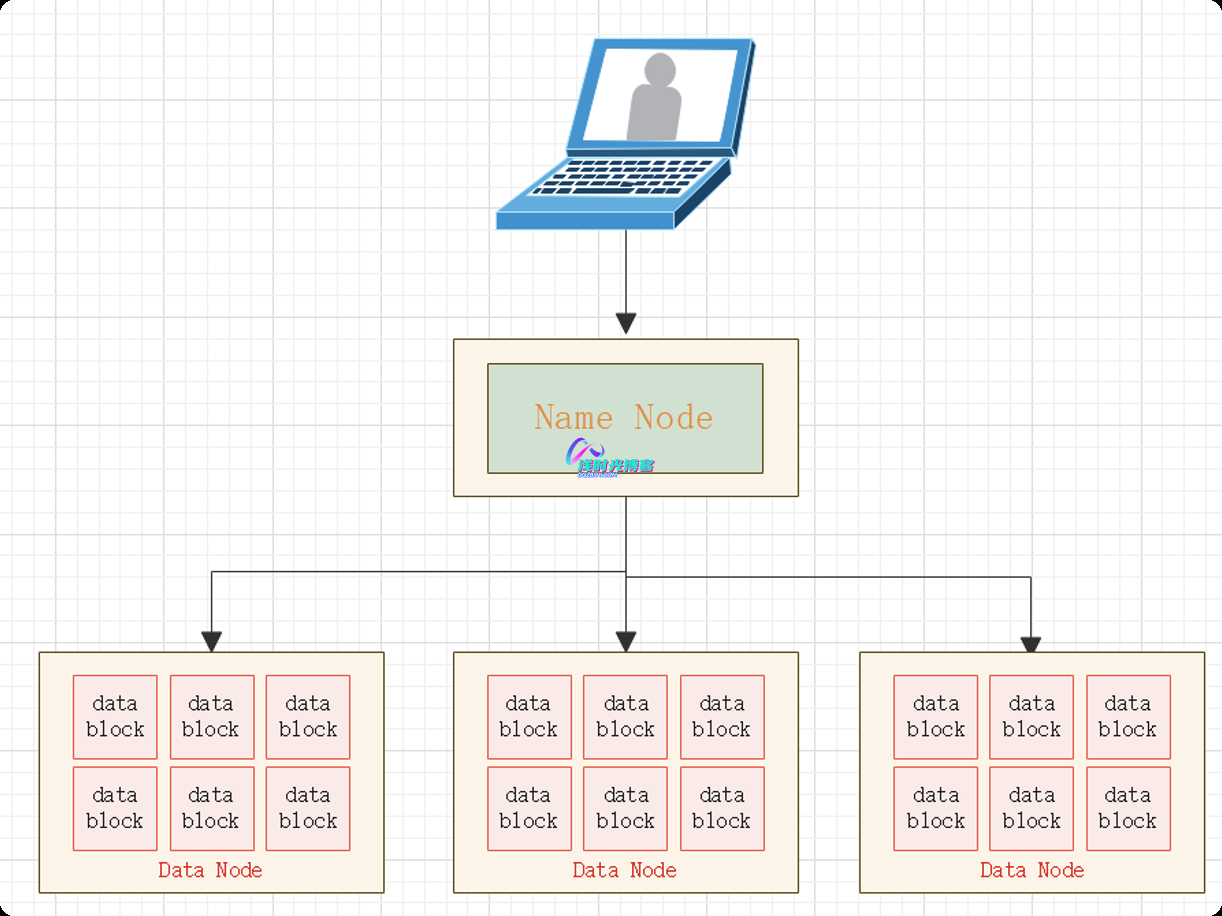
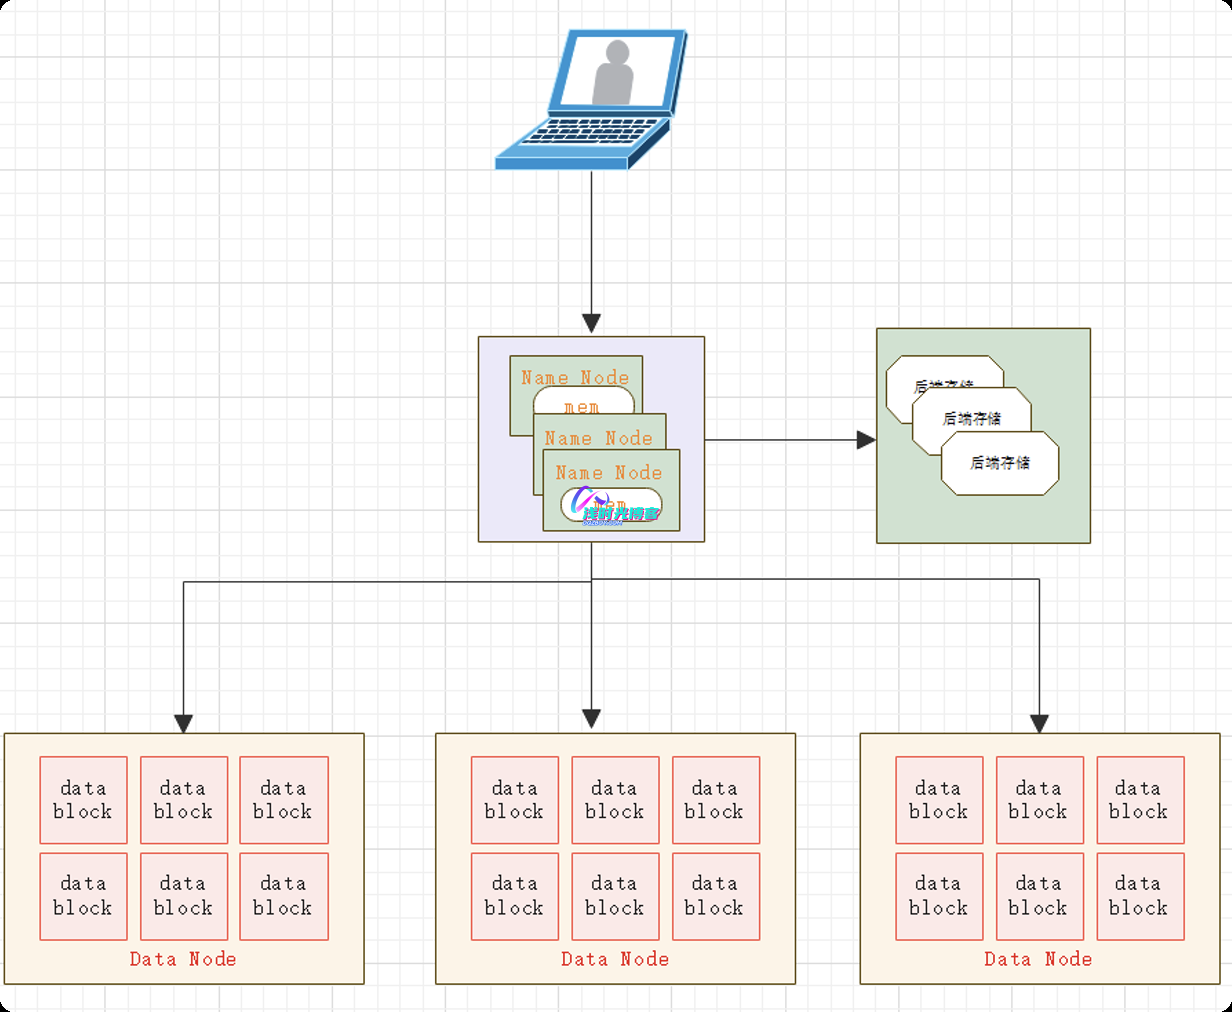
NameNode 宕机,所有数据就组不回来,所以元数据服务必须做高可用。元数据密集但极小(几 k 到几百 k),为高性能一般常驻内存;宕机即丢,就得持久化。但文件一改元数据就得改,大量随机写磁盘很慢,通行做法不是直接改源元数据,而是把修改请求顺序追加记录(类似 Redis 的 AOF,靠重放恢复、速度慢),再进一步干脆把这份记录放到第三方存储服务上。
Ceph、FastDFS、GlusterFS
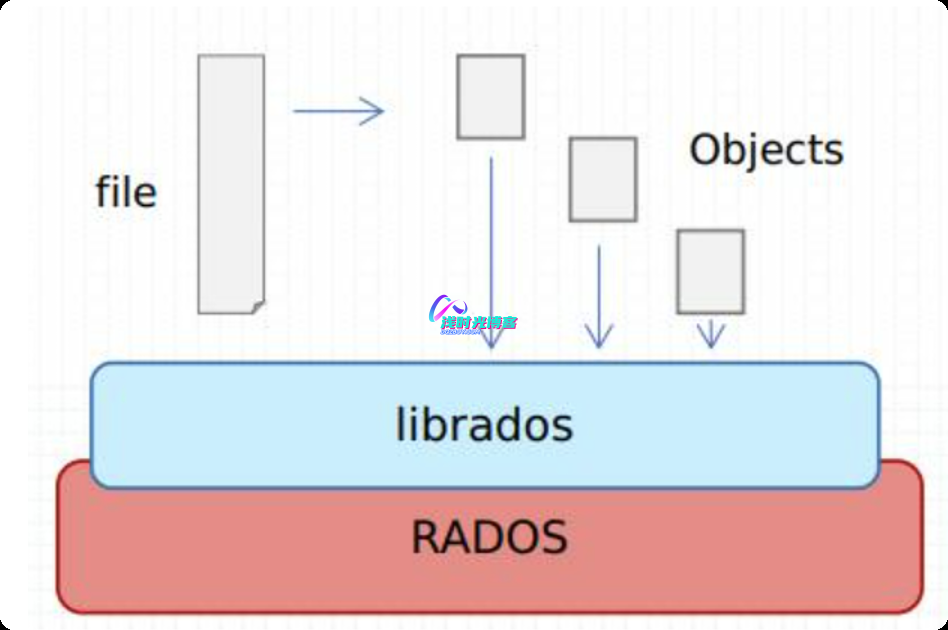
Ceph:去中心化的对象式存储。每个数据流被切成固定大小(默认 4M,可自定义)的对象做原子存取,底层是 RADOS 存储集群;客户端经 libeRADOS API 提交(支持 C、C++、Java、Python、Ruby、PHP 等)。一套统一系统同时提供对象、块、文件存储,可支撑 PB 乃至 EB 级数据。针对”元数据服务器容易成瓶颈”的问题,Ceph 的思路是不查而是算:存取时对对象做 hash、经 CRUSH 算法实时算出落点,因此没有中心元数据节点,计算对 CPU 消耗很小。特性:数据分布均衡、并行度高,支持上千节点;故障域分隔、数据强一致、无单点、自动管理,部署需 3 台以上奇数节点;去中心化,吞吐随节点增加线性增长。

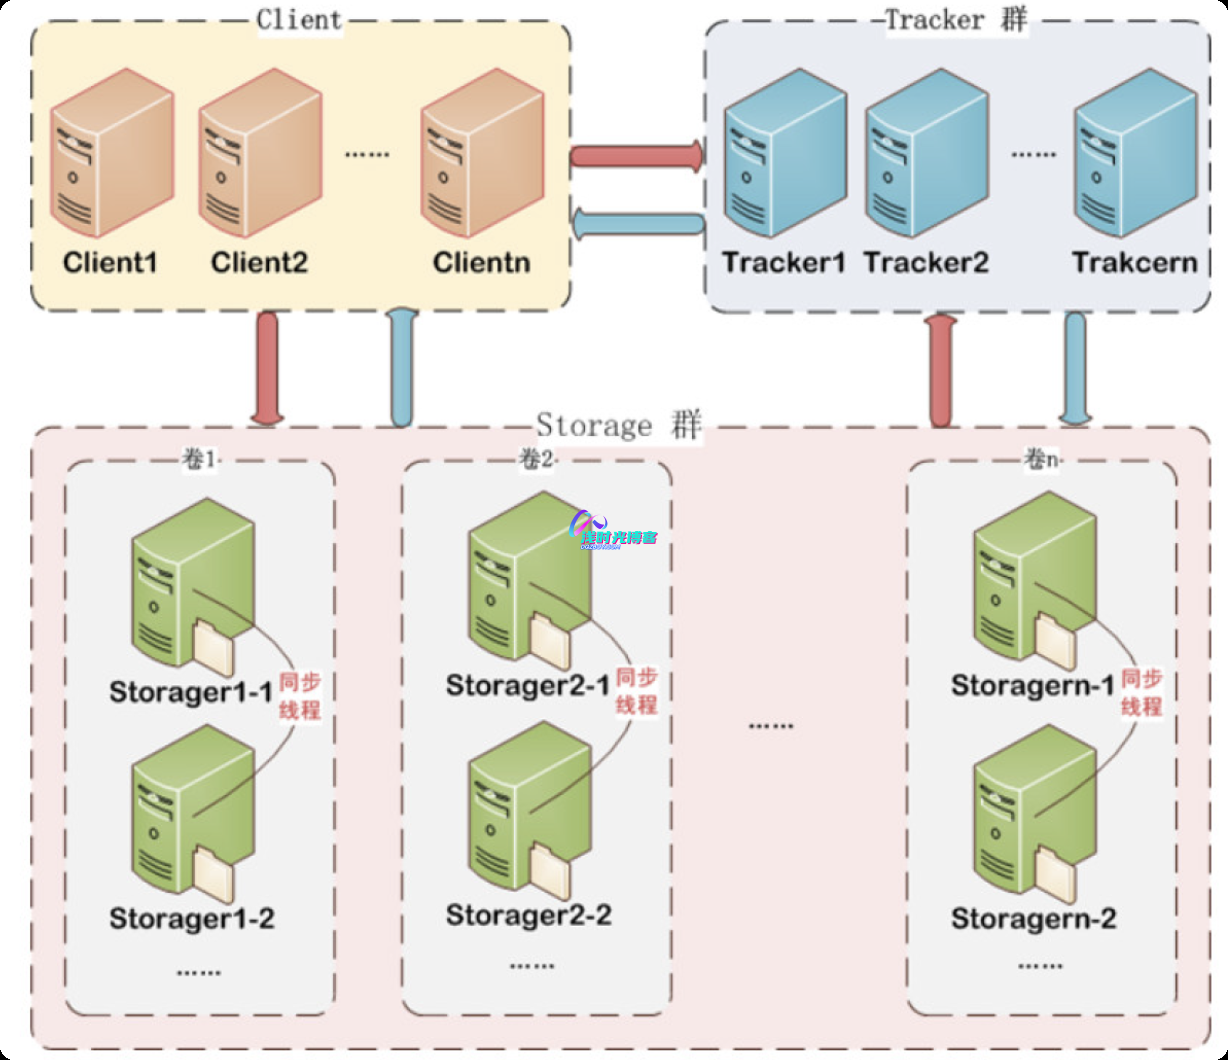
FastDFS:C 语言写的开源轻量级分布式文件系统,负责文件存储、同步、上传下载,解决大容量存储和负载均衡,官方建议单文件 4K-500M,适合相册站、视频站这类中小文件在线服务。架构三块:客户端提供 upload、download、append、delete 接口;Tracker 做负载均衡与调度,元信息全在内存、不持久化,各 Tracker 完全对等、随时可扩;Storage 按 group 组织,组内互为备份、容量取组内最小者,直接用操作系统文件系统管文件。文件不分块存储,文件 ID 由 FastDFS 生成、不需要 name server;组内靠 binlog(只记文件名等元信息)后台同步,进度以时间戳记录,因此集群时钟要同步;支持与 Apache/Nginx 无缝衔接、相同内容只存一份、在线扩容、断点续传。
GlusterFS:Scale-Out 的开源分布式文件系统,借 TCP/IP 或 InfiniBand RDMA 把分散资源聚成单一全局命名空间,可扩展到数 PB、数千客户端。弹性哈希让它在存储池内直接定位任意数据分片,不依赖元数据服务器,消除单点和瓶颈;数据用 EXT3、XFS 等标准文件系统存放,节点故障不影响访问、可后台增量自修复;支持 NFS、CIFS、HTTP、FTP、SMB 及原生协议,兼容 POSIX,现有应用不用改。卷类型七种:分布式卷(HASH 散列,文件级 RAID0、不容错)、条带卷(类 RAID0,大文件读得快)、复制卷(文件级 RAID1,读升写降)、分布式条带卷、分布式复制卷、条带复制卷(类 RAID10)、分布式条带复制卷(常用于类 Map Reduce)。

六个系统横向对比与选型
| 对比说明 | TFS | FastDFS | MFS | GlusterFS | Ceph | HDFS |
| 开发语言 | C++ | C | C | C | C++ | Java |
| 数据存储 | 块 | 文件/Trunk | 块 | 文件/块 | 对象/文件/块 | 大文件 |
| 在线扩容 | 支持 | 支持 | 支持 | 支持 | 支持 | 支持 |
| 冗余备份 | 支持 | 支持 | 支持 | 支持 | 支持 | 支持 |
| 单点故障 | 存在 | 不存在 | 存在 | 不存在 | 不存在 | 2.0之前存在 |
| 复杂度 | 复杂 | 简单 | 复杂 | 复杂 | 复杂 | 简单 |
| 适用场景 | 跨集群的小文件 | 单集群的中小文件 | 单集群的大中文件 | 跨集群云存储 | 对象、文件、块 | 大文件,日志存储和日志分析 |
选型粗略记:FastDFS 管小图片、音频小视频这类单集群中小文件;GlusterFS 适合跨集群大文件,小文件性能差;对象、块、文件都要、场景更复杂的上 Ceph;HDFS 专注大文件与日志存储分析;MFS/TFS 存在单点故障,新集群要评估清楚。










暂无评论内容