

大数据就两个问题:怎么存、怎么分析。Hadoop 的核心对应得很整齐——HDFS 管存储,MapReduce 管分析。这篇记录在 3 台虚拟机上从零搭 hadoop-3.1.2 集群的完整过程。
环境规划与基础准备
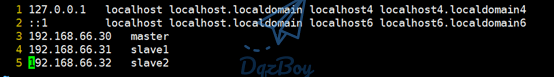
三台机器:192.168.66.30 为 master,192.168.66.31 为 slave1,192.168.66.32 为 slave2。版本为 hadoop-3.1.2 加 jdk-8u201,安装包分别取自 Apache Hadoop 官方下载页和 Java SE Development Kit 8u241 页面。
vim 开启行号,后面对配置文件少踩坑:
[root@master ~]# vim /root/.vimrc
set nu
设置主机名与 hosts 解析:
[root@master ~]# hostnamectl set-hostname master
[root@master ~]# vim /etc/hosts
配置免密登录。客户端和服务端都是本机这一套,只要把 ssh 生成的公钥存到服务端的 authorized_keys 文件即可:
[root@master ~]# ssh-keygen
[root@master ~]# ssh-copy-id 192.168.66.31
[root@master ~]# ssh-copy-id 192.168.66.32
三台机器全部关闭防火墙:
[root@master ~]# systemctl stop firewalld;systemctl disable firewalld

[root@master ~]# for i in 192.168.66.3{1,2};do echo ">>> $i";ssh $i "systemctl stop firewalld;systemctl disable firewalld;systemctl status firewalld | grep Active";done
>>> 192.168.66.31
   Active: inactive (dead)
>>> 192.168.66.32
   Active: inactive (dead)
配置 JAVA 与 Hadoop 环境变量
两个包解压到 /usr/local,/etc/profile 末尾追加 Java、Hadoop 路径和各守护进程的运行用户变量,source 生效后用 java -version 验证:
# 把下载的hadoop、JDK解压到/usr/local
[root@master ~]# tar -xf hadoop-3.1.2.tar.gz -C /usr/local/
[root@master ~]# tar -xf jdk-8u201-linux-x64.tar.gz -C /usr/local/

# 添加环境变量最后的效果
[root@master ~]# vim /etc/profile
#-----java path---------#
export JAVA_HOME=/usr/local/jdk1.8.0_201
export JRE_HOME=$JAVA_HOME/jre
export CLASSPATH=.:$JAVA_HOME/lib:$JRE_HOME/lib
export PATH=$JAVA_HOME/bin:$PATH
#------hadoop path-------#
export PATH=$PATH:/usr/local/hadoop-3.1.2/bin:/usr/local/hadoop-3.1.2/sbin
export HDFS_NAMENODE_USER="root"
export HDFS_DATANODE_USER="root"
export HDFS_SECONDARYNAMENODE_USER="root"
export YARN_RESOURCEMANAGER_USER="root"
export YARN_NODEMANAGER_USER="root"

# 环境变量生效
[root@master ~]# source /etc/profile

# 测试JAVA是否可以使用
[root@master ~]# java -version
改六个配置文件
都在 hadoop 的 etc/hadoop 目录下。hadoop-env.sh 里显式指定 Java 安装路径:
[root@master hadoop]# vim hadoop-env.sh
# The java implementation to use.
export JAVA_HOME=/usr/local/jdk1.8.0_121		//输入Java安装路径
core-site.xml 定 HDFS 的 URI(文件系统://namenode标识:端口号,这里 hdfs://master:9000)和本地临时目录:
# 注意修改第4行代码中的master,根据自身服务器主机名,修改为自己的主机名字
[root@master hadoop]# vim core-site.xml
<configuration>
        <property>
                <name>fs.default.name</name>
                <value>hdfs://master:9000</value>
                 <description>HDFS的URI,文件系统://namenode标识:端口号</description>
        </property>
        <property>
                <name>hadoop.tmp.dir</name>
                <value>/usr/hadoop/tmp</value>
                <description>namenode上本地的hadoop临时文件夹</description>
        </property>
</configuration>
hdfs-site.xml 定 namenode 元数据目录、datanode 数据块物理目录、副本数(默认 3,应小于 datanode 机器数量,这里配 1)、secondary 的 9001 与 web 端 50070 地址。存放数据的 /usr/hadoop 需要手动创建,其余目录会自动生成:
# 注意标红处为Hadoop存放数据的文件,需要创建,根据自身创建的目录填写;
[root@master hadoop]# mkdir /usr/hadoop   //其余的目录会自动生成
[root@master hadoop]# vim hdfs-site.xml

# 注意修改代码中的master,根据自身服务器主机名,修改为自己的主机名字,标红的IP改为自己的IP地址
<configuration>
        <property>
                <name>dfs.name.dir</name>
                <value>/usr/hadoop/hdfs/name</value>
                <description>namenode上存储hdfs名字空间元数据 </description>
        </property>
        <property>
                <name>dfs.data.dir</name>
                <value>/usr/hadoop/hdfs/data</value>
                <description>datanode上数据块的物理存储位置</description>
        </property>
        <property>
                <name>dfs.replication</name>
                <value>1</value>
                <description>副本个数,配置默认是3,应小于datanode机器数量</description>
        </property>
	<property>
		<name>dfs.namenode.secondary.http-address</name>
		<value>master:9001</value>
	</property>
	<property>
		<name>dfs.http.address</name>
		<value>192.168.66.30:50070</value>
	</property>
</configuration>
mapred-site.xml 让 MapReduce 跑在 yarn 上,配 jobhistory 的地址与 done 目录(改前先备份一份):
# 复制一份出来,再进行修改
[root@master hadoop]# cp mapred-site.xml mapred-site.xml_bak

# 注意修改代码中的master(两处)根据自身服务器主机名,修改为自己的主机名字
[root@master hadoop]# vim mapred-site.xml
<configuration>
        <property>
		<name>mapreduce.framework.name</name>
		<value>yarn</value>
	</property>
	<property>
		<name>mapreduce.jobhistory.address</name>
		<value>master:10020</value>
	</property>
	<property>
		<name>mapreduce.jobhistory.webapp.address</name>
			<value>master:19888</value>
	</property>
	<property>
		<name>mapreduce.jobhistory.done-dir</name>
		<value>/history/done</value>
	</property>
	<property>
		<name>mapreduce.jobhistory.intermediate-done-dir</name>
		<value>/history/done_intermediate</value>
	</property>
</configuration>
yarn-site.xml 配 resourcemanager 主机名、mapreduce_shuffle 辅助服务和 web 地址(端口 8099 不要删):
# 注意修改代码中的master和倒数第三行的ip地址(:8099不要删除),根据自身服务器主机名,修改为自己的主机名字,标红的IP改为自己的IP地址

<configuration>
	<property>
		<name>yarn.resourcemanager.hostname</name>
		<value>master</value>
	</property>
	<property>
		<name>yarn.nodemanager.aux-services</name>
		<value>mapreduce_shuffle</value>
	</property>
	<property>
		<name>yarn.resourcemanager.webapp.address</name>
		<value>192.168.66.30:8099</value>
	</property>
</configuration>
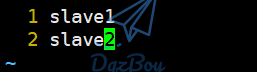
slave 文件列出两个子节点:
[root@master ~]# vim /usr/local/hadoop-3.1.2/etc/hadoop/slave分发到 slave 节点
写个脚本用 rsync 把程序目录、profile、hosts、数据目录一起同步给两台 slave。注意三台虚拟机的配置文件是一样的,无须把 master 改成 slave1、slave2;连上子节点执行 source /etc/profile 让环境变量生效:
# 将配置文件和二进制文件传给slave
[root@master ~]# vim scp_hadoop.sh
#!/bin/bash
slave_ip=("192.168.66.31" "192.168.66.32")
for i in $slave_ip;
do
  echo ">>> $i"
  rsync -av /usr/local/hadoop-3.1.2 $i:/usr/local/
  rsync -av /etc/profile $i:/etc/
  rsync -av /etc/hosts $i:/etc/
  rsync -av /usr/hadoop $i:/usr/
done

# 注意三台虚拟机的配置文件一样的,!!无须!! 将master修改为slave1,slave2;SSH连接到slave1、slave2,生效环境变量文件
[root@master ~]# ssh slave1
[root@slave1 ~]# source /etc/profile
[root@slave1 ~]# exit
格式化、启动与验证
在 master 上格式化 namenode。格式化会在前面手动创建的目录里建新目录,要保证当前用户对该目录有 x 权限:
[root@master ~]# hdfs namenode –format启动 NameNode 和 DataNode 守护进程:
[root@master ~]# start-dfs.sh启动 ResourceManager 和 NodeManager,随后 jps 验证:
[root@master ~]# start-yarn.sh
# 启动验证:
# 执行jps命令,有如下进程,说明Hadoop正常启动
[root@master ~]# cd /usr/hadoop/hadoop-2.7.3
[root@master hadoop-2.7.3]# jps
8690 SecondaryNameNode
9300 Jps
8484 DataNode
9014 NodeManager
8874 ResourceManager
8319 NameNode
两个最常见的坑:从节点忘了 source /etc/profile;免密没配好导致 start-dfs.sh 批量失败——格式化之前先用 ssh 试一把子节点更省事。











暂无评论内容